
De Powerdobs referentiearchitecturen voor Microsoft Fabric
De medaillonaanpak in Fabric, uitgewerkt in twee architecturen: Fabric Light en Fabric StandaardIn het kort
Voor wie: organisaties die een dataplatform op Microsoft Fabric willen opzetten of hun huidige inrichting willen toetsen.
Doorlooptijd: architectuursessie van een dagdeel; keuze en doelarchitectuur binnen een week.
Vorm: architectuursessie tegen vaste prijs.
Resultaat: de keuze tussen Fabric Light en Fabric Standaard, een doelarchitectuur en de eerste stap naar implementatie.
Analytics-toepassingen zijn er in veel vormen, en het onderliggende dataplatform kan op veel manieren worden ingericht. Om structuur en houvast te bieden, starten we bij Powerdobs elke implementatie vanuit een referentiearchitectuur en werken we volgens de medaillonaanpak.
In dit artikel leggen we uit hoe de medaillonaanpak werkt in Fabric en hoe die terugkomt in onze twee referentiearchitecturen: Fabric Light en Fabric Standaard.
De medaillonaanpak in Microsoft Fabric
Het woord medaille zegt het al: we onderscheiden in een dataplatform drie lagen, een bronzen, een zilveren en een gouden laag. In Fabric leven al deze lagen in OneLake. Daardoor kan elke Fabric-engine (Spark, T-SQL en Power BI) dezelfde data lezen zonder die te kopiëren.
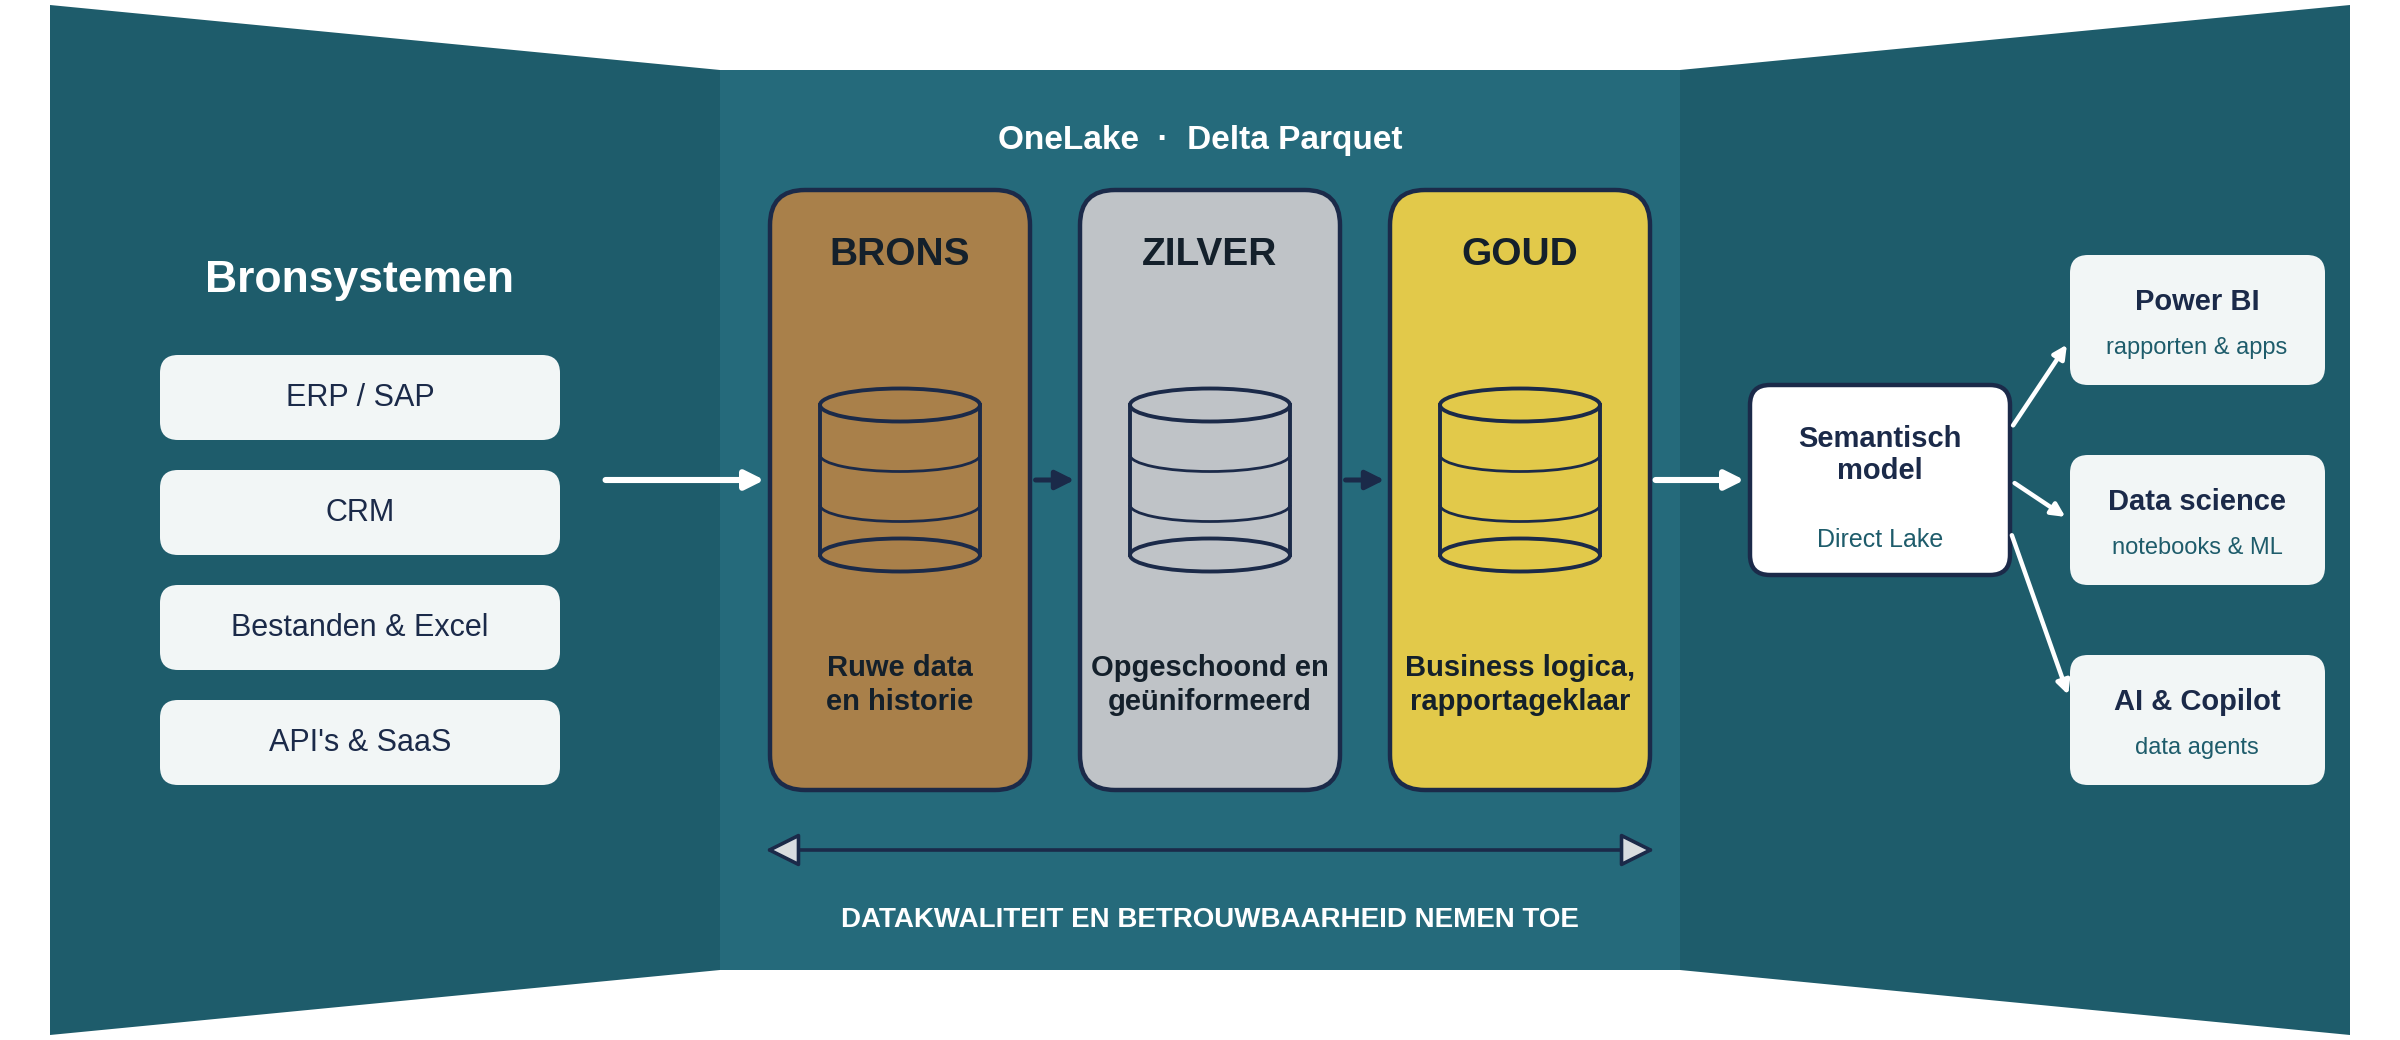
Data wordt niet vanzelf goud. Daarom lichten we aan de hand van een voorbeeld toe wat er in elke laag gebeurt. In het voorbeeld bouwen we een dataplatform voor een autobedrijf dat auto’s van Toyota en Lexus verkoopt. De data van Toyota ziet er anders uit dan de data van Lexus, maar we willen over beide merken samen rapporteren.
Bronzen laag: “Raw”
Beide merken hebben systemen met de voorraad, de verkochte auto’s en klantgegevens. De bestanden zijn in verschillende formaten opgeslagen en de structuur verschilt per merk.
In de bronzen laag kopiëren we deze data één op één, onaangepast vanuit de bron, naar OneLake. Elk bronbestand of elke brontabel wordt een losse tabel. In Fabric gebruiken we hiervoor pipelines, Dataflows Gen2, Mirroring of shortcuts, afhankelijk van de bron. Bestanden landen eerst in de Files-sectie van een Lakehouse en worden daarna als Delta-tabel opgeslagen.
In de bronzen laag houden we optioneel historie bij. Daarmee kun je zien hoe een tabel er op een bepaalde dag in het verleden uitzag.
Zilveren laag: “Cleansed and conformed”
In de zilveren laag maken we de losse tabellen begrijpelijk en compleet. We koppelen de data van Toyota en Lexus aan elkaar. Staat in het verkoopbestand van Toyota het model en de kleur in één kolom en bij Lexus in twee kolommen, dan uniformeren we dat hier. Onbekende waarden maken we herleidbaar en valideren we met de business. Bijzondere tekens en overbodige spaties verwijderen we.
Is de zilveren laag compleet, dan hebben we volledige en uniforme tabellen voor het hele autobedrijf, in plaats van tabellen per merk. In Fabric doen we deze transformaties in notebooks (PySpark of Spark SQL). Ook houden we waar nodig historie bij met slowly changing dimensions. Een voorbeeld van een notebook, geschreven in SQL, dat data uit twee bronzen tabellen samenvoegt.
-- Zilver: Toyota en Lexus uniform maken (Spark SQL)
CREATE OR REPLACE TABLE zilver.verkoop AS
SELECT 'Toyota' AS merk, order_id, verkoopdatum,
       TRIM(SPLIT(model_kleur, '/')[0]) AS model,
       TRIM(SPLIT(model_kleur, '/')[1]) AS kleur,
       verkoopprijs, inkoopprijs
FROM brons.toyota_verkoop
UNION ALL
SELECT 'Lexus', ordernummer, datum_verkoop,
       TRIM(model), TRIM(kleur), prijs_verkoop, prijs_inkoop
FROM brons.lexus_sales;
Gouden laag: “Curated”
Op de zilveren laag voegen we business logica en berekeningen toe. Zo ontstaat de gouden laag. Business logica is bijvoorbeeld een indicator die aangeeft dat een auto langer dan 30 dagen op voorraad staat. Een berekening is bijvoorbeeld de marge op de verkoop van een auto. We modelleren de gouden laag als sterschema, met feiten- en dimensietabellen.
Bovenop de gouden laag maken we in Fabric een semantisch model. Dat is de bron voor Power BI rapportages of AI toepassingen.
Drie lagen is een uitgangspunt, geen wet
Je hoeft niet rigide vast te houden aan precies drie lagen. Soms is een aparte landingszone of een extra laag tussen zilver en goud zinvol. Zolang duidelijk is waar landing, raw, base, enriched, curated en semantic “leven”, zit je goed.
Twee referentiearchitecturen
De medaillonaanpak is in beide architecturen hetzelfde. Het verschil zit in hoever we de lagen fysiek van elkaar scheiden. Het belangrijkste keuzecriterium is het aantal bronnen: tot en met drie bronnen kun je het dataplatform kleiner houden met Fabric Light, bij meer dan drie bronnen is Fabric Standaard verstandiger.
Fabric Light: schema’s in één Warehouse of Lakehouse
Fabric Light is de compacte start voor organisaties met een beperkt aantal bronnen en een duidelijke rapportagebehoefte. Alle drie de lagen leven als schema’s in één Warehouse of één Lakehouse. Daarop wordt één semantisch model gemaakt dat de Power BI-rapporten voedt.
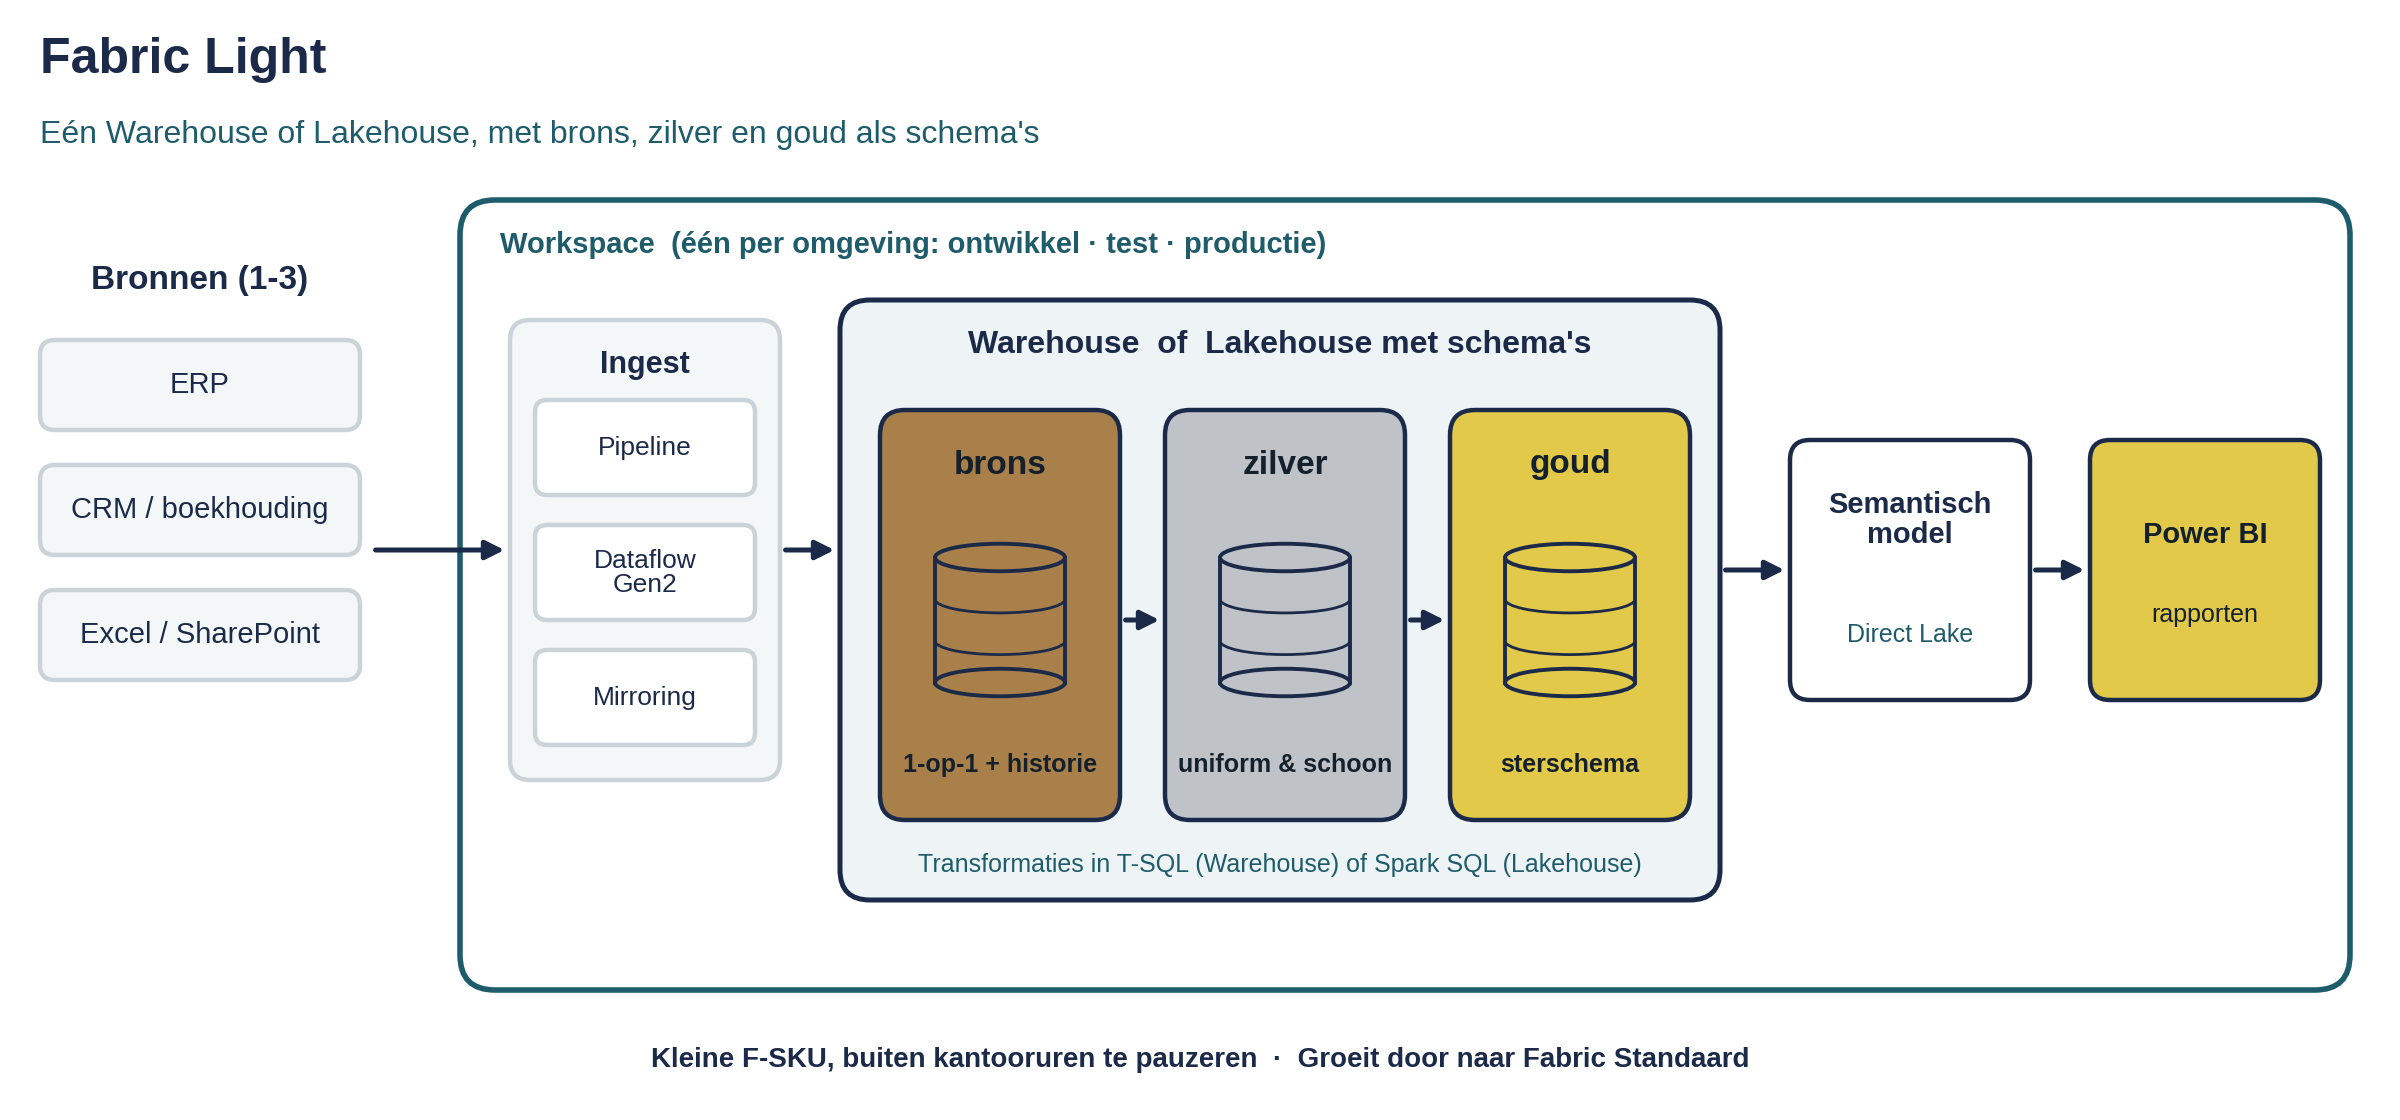
| Laag | Waar in Fabric Light | Voorbeeld autobedrijf |
|---|---|---|
| Brons | Schema brons, gevuld via pipeline, Dataflow Gen2 of Mirroring | brons.toyota_verkoop, brons.lexus_sales |
| Zilver | Schema zilver, views of tabellen in T-SQL of Spark SQL | zilver.verkoop, zilver.voorraad, zilver.klant |
| Goud | Schema goud, sterschema | goud.fct_verkoop (met marge), goud.dim_auto (met indicator > 30 dagen voorraad) |
| Semantisch | Eén semantisch model dat Power BI voedt | Verkoop- en voorraadrapport per merk en model |
Warehouse of Lakehouse? Deze keuze is afhankelijk van verschillende factoren. We bepalen per situatie wat de beste optie is.
Waarom Fabric Light?
- Lage kosten: draait op een kleine capacity.
- Eenvoudig beheer: één lakehouse/warehouse, en één workspace per omgeving (DEV, TST, PRD).
- Doorgroeien zonder opnieuw te beginnen: de schema’s brons, zilver en goud verhuizen bij groei naar de aparte Lakehouses en Warehouse van Fabric Standaard.
Fabric Standaard: het volledige dataplatform
Fabric Standaard is ons uitgangspunt voor organisaties met meer dan drie bronnen, grotere datavolumes of meerdere teams. Elke medaillonlaag krijgt een eigen Lakehouse of Warehouse in een eigen workspace. Daardoor kun je per laag toegang, capaciteit en releases los van elkaar regelen.
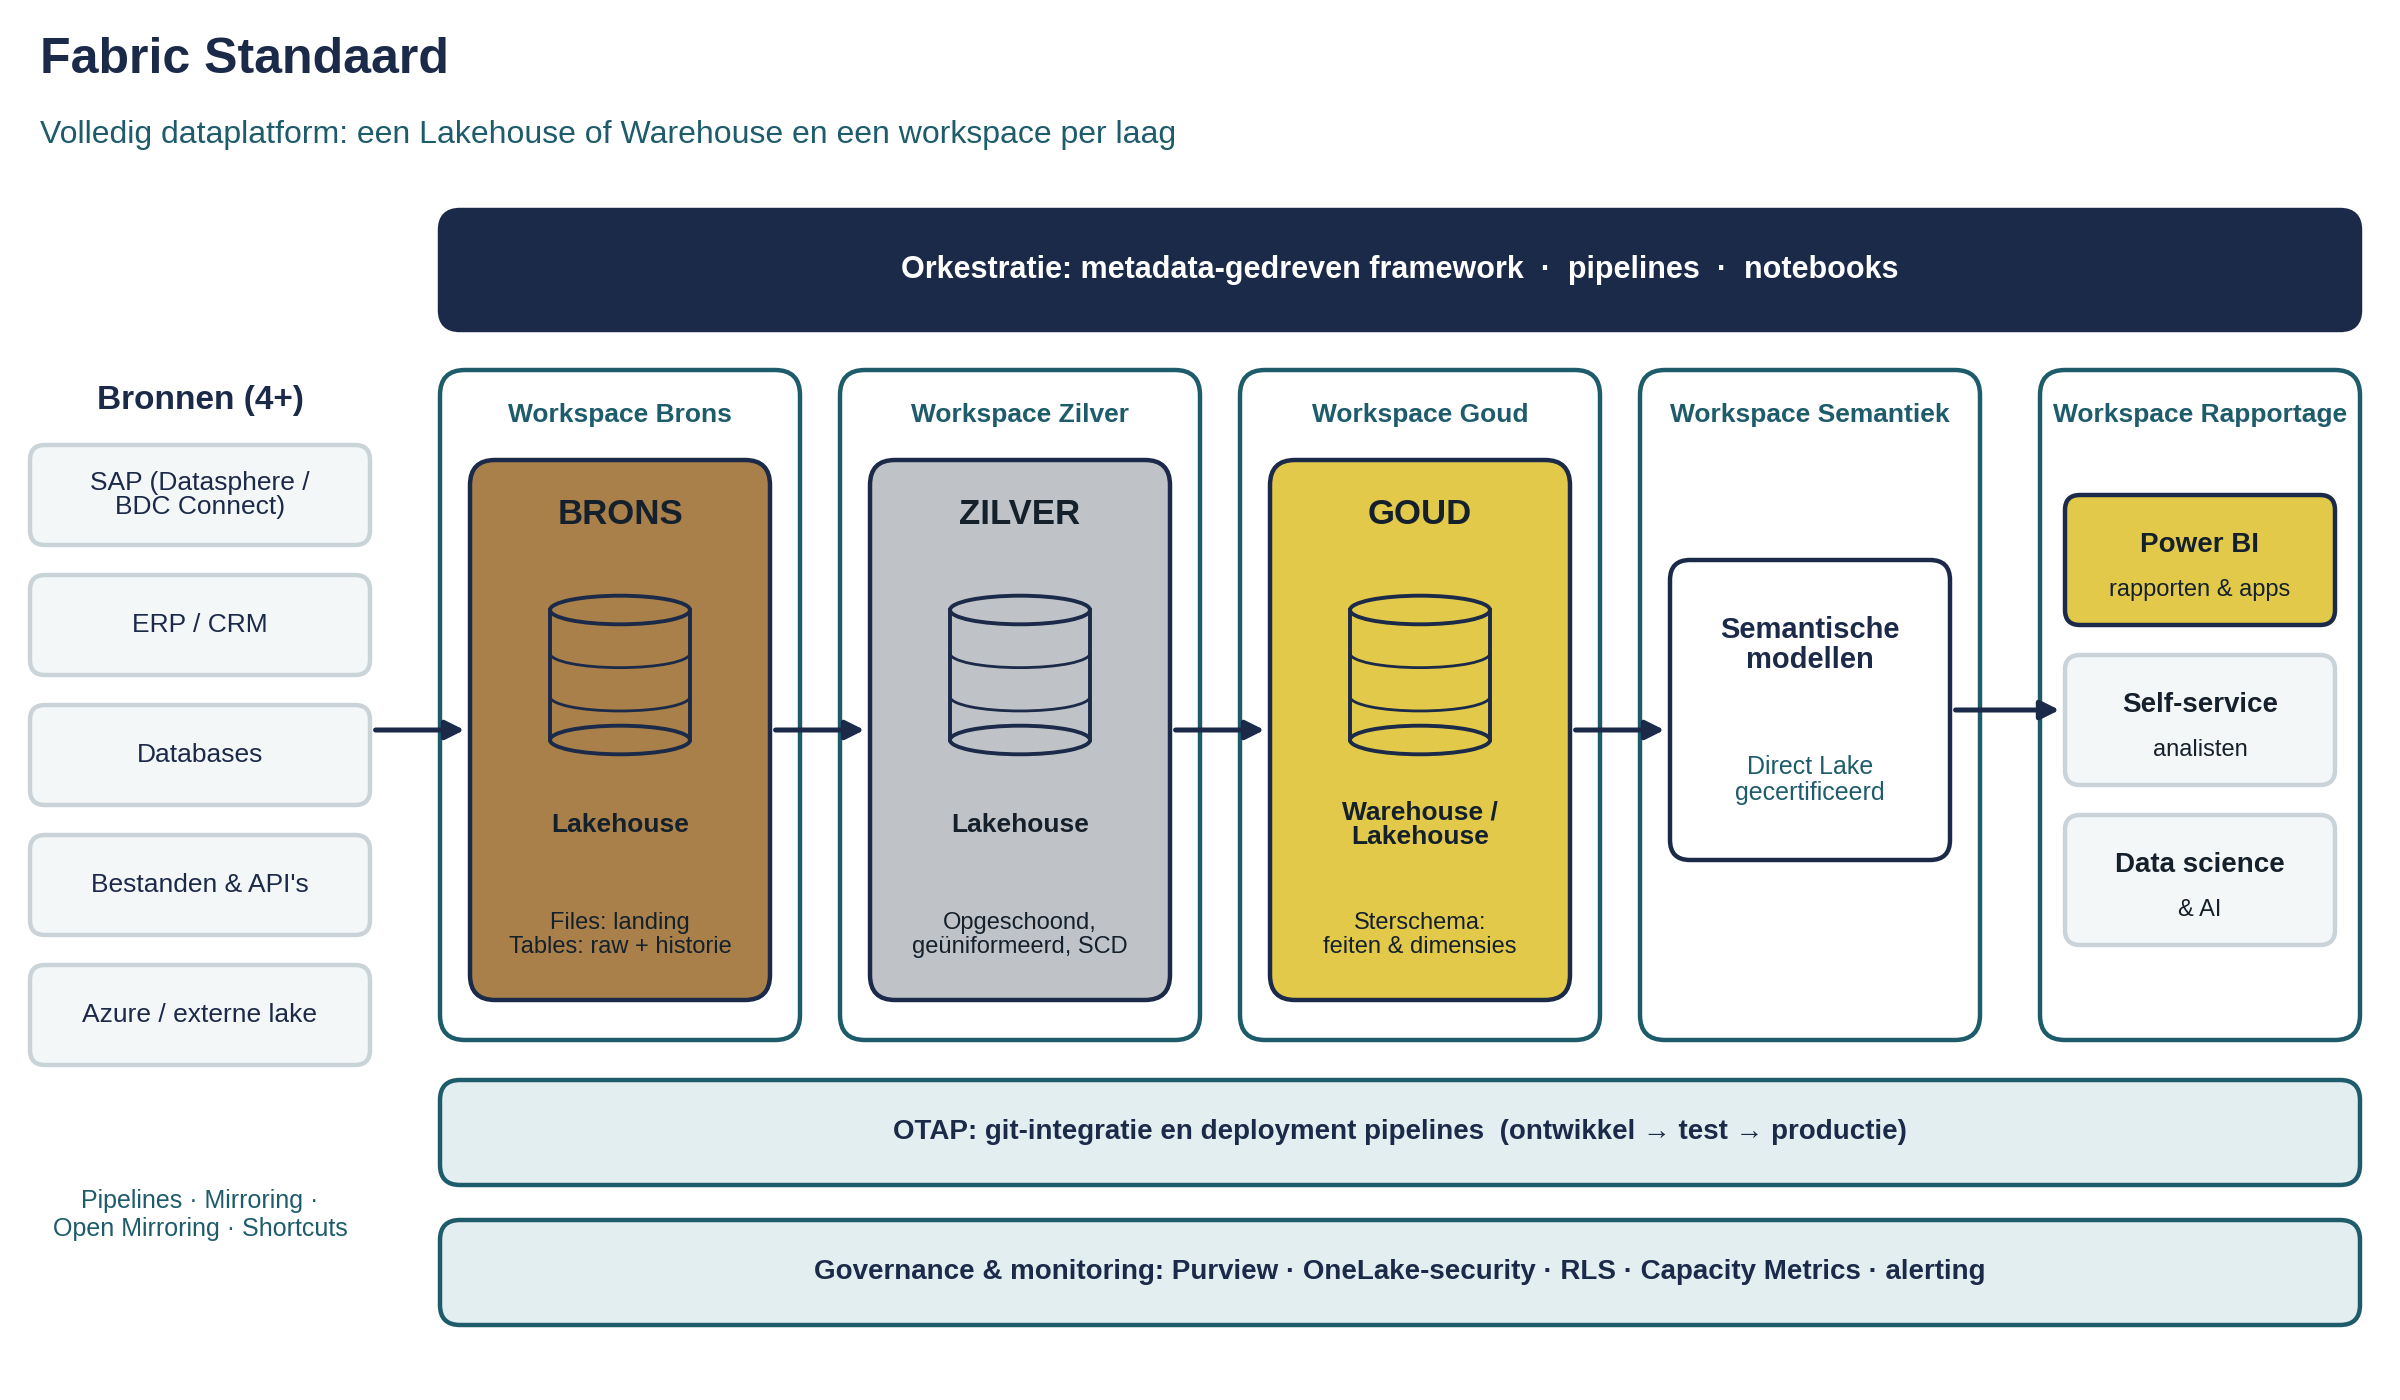
| Laag | Waar in Fabric Standaard | Voorbeeld autobedrijf |
|---|---|---|
| Brons | Workspace Brons met een Lakehouse: Files als landingszone, Tables voor ruwe data en historie | Dealerbestanden van Toyota en Lexus landen als bestanden en worden per lading met laaddatum opgeslagen |
| Zilver | Workspace Zilver met een Lakehouse; transformaties in notebooks | Uniforme tabellen voor verkoop, voorraad en klanten van beide merken, met historie op klanten |
| Goud | Workspace Goud met een Warehouse of Lakehouse; sterschema | Feiten verkoop en voorraad, dimensies auto, klant en datum, inclusief marge en voorraadindicator |
| Semantisch | Workspace Semantiek | Eén gecertificeerd model “Verkoop en voorraad” voor de hele organisatie |
| Rapportage | Workspace Rapportage met rapporten en een Power BI-app | Managementrapportage, voorraadsturing en self-service voor analisten |
Daarnaast bevat Fabric Standaard een aantal bouwblokken die het platform beheersbaar maken:
- Metadata-gedreven framework: nieuwe bronnen en tabellen voegen we toe via configuratie in plaats van per tabel een pipeline te bouwen. Een nieuwe bron (bijvoorbeeld een derde automerk) is daardoor snel aangesloten.
- Breed scala aan bronkoppelingen: pipelines, Mirroring, Open Mirroring en shortcuts. SAP-data ontsluiten we samen met zusterbedrijf Interdobs via SAP Datasphere of SAP Business Data Cloud Connect (voor Fabric verwacht in Q1 2027). Voor S/4HANA starten we met de kant-en-klare modellen van StarShelf.
- OTAP: git-integratie en deployment pipelines, zodat wijzigingen gecontroleerd van ontwikkel via test naar productie gaan.
- Governance en monitoring: Purview, OneLake-security, row-level security, Capacity Metrics en alerting.
Welke architectuur past bij jou?
| Fabric Light | Fabric Standaard | |
|---|---|---|
| Aantal bronnen | 1 tot en met 3 | Meer dan 3 |
| Medaillonlagen | Schema’s in één Warehouse of Lakehouse | Eigen Lakehouse of Warehouse per laag |
| Workspaces | Eén per omgeving | Eén per laag, per omgeving |
| Transformaties | T-SQL, Spark SQL of PySpark | PySpark, T-SQL, Spark SQL en/of metadata-gedreven |
| Semantisch model | In dezelfde workspace | Eigen workspace, eventueel gescheiden van rapporten |
| Teams | Eén BI-team of BI-specialist | Data engineering- en BI-teams |
| Capaciteit | Kleine F-SKU, pauzeerbaar | Gedimensioneerd op het werkelijke verbruik |
| Groeipad | Naar Fabric Standaard | Uitbreiden met domeinen en extra capaciteiten |
Wordt SAP BW en/of Azure Data Factory / Synapse Analytics gebruikt?
Dan kan WavePath helpen met een gedeeltelijk geautomatiseerde migratie.
Komt je data uit SAP S/4HANA?
Dan geeft StarShelf een vliegende start: kant-en-klare sterschema’s volgens de medaillonaanpak, met de landingstabellen in brons en het sterschema in goud.
De twee architecturen zijn stapelbaar. Je kunt klein beginnen met Fabric Light en doorgroeien naar Fabric Standaard zonder opnieuw te beginnen, omdat de medaillonlagen in beide gelijk zijn.
Verder lezen
- Klantcase: Louwman zet het data lakehouse in haar kracht
- Klantcase: De Jong Duke realiseert een cultuuromslag met data
- Klaar voor de volgende stap? Lees Fabric implementatie en migratie.
- Wil je weten hoe je huidige Fabric-omgeving ervoor staat? Start met de Health Scan.
- Twijfel je tussen Fabric en Databricks? Lees het blog Microsoft Fabric vs Azure Databricks: welke keuze past bij jouw organisatie?
Plan een architectuursessie
Wil je weten welke referentiearchitectuur bij jouw organisatie past? In een architectuursessie van een dagdeel lopen we je bronnen, teams en rapportagebehoefte door en kiezen we tussen Fabric Light en Fabric Standaard. Vertel ons alvast hoeveel bronnen je hebt en wie het platform gaat beheren.
Of mail direct naar info@powerdobs.nl.